
Et af de argumenter, man ofte møder i forbindelse med linkbuilding, er diversitet.
Links skal komme fra forskellige domæner. De skal gerne ligge hos forskellige hostingudbydere. Ankerteksterne skal varieres, og links skal komme fra websites med forskellige emner, styrker og profiler.
Tidligere blev der også lagt stor vægt på forskellige IP-adresser.
På et regneark kan resultatet se overbevisende ud.
Ti forskellige domæner er trods alt ti forskellige domæner.
Men spørgsmålet er, om domænediversitet også er det samme som reel diversitet.
For hvis forskellige websites anvender den samme model til at publicere og distribuere eksterne links, kan der opstå et mønster på tværs af domænerne – også selv om domænenavne, IP-adresser, design og indhold er forskellige.
Og måske er det netop dét, der er mere interessant end IP-adressen.
Linkkataloget er ikke nogen ny opfindelse
Når vi taler om linkkataloger, link-hubs og netværk i dag, er det værd at huske, at linkkataloget oprindeligt havde en helt anden funktion.
I internettets tidligere år var kataloger en reel del af den måde, vi fandt information og websites på.
Websites blev organiseret efter emner og kategorier. Brugeren kunne bevæge sig gennem et hierarki og finde websites om eksempelvis biler, rejser, virksomheder, computere eller sport.
Yahoo! Directory, DMOZ og i Danmark blandt andet Jubii er eksempler fra denne periode.
Links var altså ikke nødvendigvis placeret i kataloget, fordi en virksomhed havde købt et SEO-link.
Linket var selve katalogets funktion.
Brugerne benyttede kataloget til at finde videre til andre dele af internettet.
Det er en væsentlig forskel i forhold til meget af det, vi i dag kalder linkkataloger.
Så kom artikeldatabaserne
Senere blev artikeldatabaser populære.
Her kunne virksomheder, skribenter og SEO-folk indsende artikler, som typisk indeholdt et eller flere links tilbage til afsenderens website.
På overfladen var modellen indholdsbaseret: Man leverede en artikel og fik mulighed for at henvise til relevante ressourcer.
Men efterhånden som links fik stadig større betydning for placeringerne i søgemaskinerne, blev artikeldatabaser en meget anvendt metode til linkbuilding.
Artikler kunne produceres i stort antal og distribueres på tværs af forskellige databaser – ikke nødvendigvis fordi databaserne havde en stor læserskare, men fordi artiklen gav mulighed for at placere et link.
Dermed ændrede formålet sig i nogle tilfælde.
Fra:
“Her er indhold, som en bruger kan finde og læse.”
til snarere:
“Her er et sted, hvor vi kan få placeret et link.”
Det minder på mange måder om noget af det, vi ser igen i dag.
Teknologien er blevet bedre. Websites ser bedre ud. Artiklerne kan produceres langt hurtigere.
Men det grundlæggende spørgsmål er stadig det samme:
Er artiklen skrevet for at få et link – eller opstår linket, fordi der var en artikel, som havde en grund til at eksistere?
Hvad er et PBN?
PBN står for Private Blog Network.
Den klassiske model består af en gruppe websites, der kontrolleres af samme ejer eller gruppe, og hvor et væsentligt formål er at skabe links til andre websites for at påvirke deres placeringer i søgemaskinerne.
En kendt metode har været at anvende udløbne domæner, som allerede havde en eksisterende backlinkprofil.
Et domæne kunne tidligere have tilhørt en virksomhed, forening, organisation eller et informationssite. Når registreringen udløb, kunne domænet overtages, nyt indhold publiceres, og den historiske linkprofil forsøges anvendt til et nyt formål.
Men et moderne linknetværk behøver ikke ligne den klassiske PBN-model.
Websites kan ligge hos forskellige hostingfirmaer. De kan anvende forskellige registratorer, DNS-udbydere, designs og CMS-systemer.
Emnerne kan også være forskellige.
Ét website handler måske om bolig, et andet om erhverv, et tredje om livsstil og et fjerde om biler.
På overfladen kan resultatet derfor ligne en bred gruppe af uafhængige websites.
Men teknisk forskellighed er ikke nødvendigvis det samme som redaktionel eller ejermæssig uafhængighed.
Fra PBN til link-hubs
Der findes også konstruktioner, som ikke nødvendigvis passer ind i den traditionelle definition af et PBN.
En model kan være forskellige former for link-hubs.
Her behøver én aktør ikke nødvendigvis eje samtlige websites.
En central aktør, platform eller markedsplads kan i stedet fungere som forbindelsesled mellem dem, der ønsker links, og en større gruppe websites, hvor artikler og links kan publiceres.
På papiret kan det give en betydelig domænediversitet.
Men igen bør man skelne mellem antallet af domæner og den reelle uafhængighed mellem dem.
Hvis de samme kunder, brancher eller kommercielle destinationer igen og igen distribueres gennem den samme gruppe websites, kan der opstå et genkendeligt strukturelt mønster – selv om domænerne teknisk set har forskellige ejere.
Det giver mening at skelne mellem flere former for diversitet:
Teknisk diversitet: Websites anvender forskellig teknisk infrastruktur.
Hosting-diversitet: Websites anvender forskellige hostingudbydere.
Domænediversitet: Links kommer fra forskellige domæner.
Design-diversitet: Websites ser forskellige ud.
Ejermæssig diversitet: Websites kontrolleres faktisk af forskellige og uafhængige aktører.
Redaktionel diversitet: Indhold og links opstår gennem selvstændige redaktionelle beslutninger.
De første former kan relativt let konstrueres.
De sidste er langt mere interessante.
Forskellige IP-adresser fortæller mindre end tidligere
Tidligere blev IP-adresser ofte tillagt stor betydning, når SEO-folk forsøgte at identificere eller skjule et linknetværk.
Hvis en større gruppe websites lå på samme IP-adresse eller inden for samme IP-område, kunne det være et oplagt teknisk fællestræk. Derfor opstod der også en hel disciplin omkring at sprede websites på forskellige IP-adresser og hostingudbydere.
Men internettets infrastruktur har ændret sig markant.
I dag ligger enorme mængder websites på cloudplatforme, CDN’er, reverse proxies og store hostingmiljøer. Helt uafhængige virksomheder, webshops, blogs og medier kan derfor dele teknisk infrastruktur uden overhovedet at have noget med hinanden at gøre.
En fælles IP-adresse er derfor ikke dokumentation for et netværk.
Men det modsatte gælder også:
Forskellige IP-adresser dokumenterer heller ikke, at websites er uafhængige.
Man kan sagtens sprede 30 websites på 30 forskellige IP-adresser.
Men hvis de samme websites optræder i det samme salgsregneark, publicerer samme type SEO-artikler, linker til de samme typer kommercielle destinationer og følger genkendelige publicerings- og linkmønstre, er IP-adresserne måske ikke det mest interessante signal.
Det er relationerne og mønstrene mellem websites, der bliver interessante.
Ingen af disse signaler behøver isoleret set at betyde ret meget. Men når flere optræder samtidig, kan de tilsammen beskrive en struktur.
Spørgsmålet er derfor i dag mindre:
“Ligger disse websites på samme IP-adresse?”
og mere:
“Hvilke relationer kan observeres mellem disse websites?”
Fra offentligt linkkatalog til linkudbyderens salgskatalog
I dag findes der stadig en form for “katalog” over websites, men det bør ikke forveksles med internettets gamle offentlige linkkataloger.
Det moderne katalog er ofte slet ikke et website, som almindelige internetbrugere besøger.
Det kan være et regneark, som linkudbyderen sender til kunden.
Det kan være en Excel- eller Google Sheets-liste med hundredvis eller tusindvis af domæner.
Det kan være en database bag et kundelogin eller en online platform, hvor kunden kan søge blandt websites, som udbyderen har adgang til at publicere på.
Typisk kan man se oplysninger som domæne, emne, SEO-metrics, estimeret trafik og pris. Nogle steder fremgår også betingelser for antal links, artikellængde og publicering.
Det er altså ikke et linkkatalog i den oprindelige betydning.
Det gamle linkkatalog var lavet til internetbrugeren, som skulle finde relevante websites.
Det nye salgskatalog er lavet til linkkøberen, som skal finde et website at placere sit link på.
Den forskel er væsentlig.
500 domæner i et regneark kan se ud som stor diversitet
Forestil dig, at en linkudbyder sender et regneark med 500 websites.
Kunden kan vælge mellem bolig, erhverv, livsstil, biler, økonomi, familie og en lang række andre emner.
Websites har forskellige designs, hostingudbydere, IP-adresser og SEO-metrics.
Kunden vælger 20 websites.
I den efterfølgende backlinkrapport ser resultatet umiddelbart imponerende ud:
20 links fra 20 forskellige domæner.
Teknisk set er der domænediversitet.
Men alle 20 websites er fundet i det samme salgskatalog og valgt med samme formål: at få placeret et SEO-link.
Det betyder naturligvis ikke, at de har samme ejer eller automatisk udgør et PBN. Nogle kan være helt almindelige uafhængige websites, der accepterer betalt indhold.
Men 20 forskellige domæner dokumenterer ikke i sig selv 20 uafhængige redaktionelle anbefalinger.
Og hvor hemmeligt er kataloget egentlig?
Her kommer vi til noget, jeg personligt lægger betydelig vægt på.
Jeg ville aldrig anvende links i min linkbuilding fra websites, der optræder på lange, mere eller mindre bredt distribuerede salgslister – komplette med domænenavne, SEO-metrics og priser på publicering.
Jeg behøver ikke engang selv opsøge dem.
Jeg modtager uopfordrede e-mails med tilbud om links og lister over websites, hvor artikler kan publiceres.
Derfor har jeg svært ved at se logikken i, at man på den ene side gør meget ud af forskellige IP-adresser og hostingfirmaer for at skabe “diversitet”, mens man på den anden side samler domænerne i et regneark med en prisliste og distribuerer det til potentielle kunder.
Det rejser et enkelt spørgsmål:
Hvis jeg kan få listen tilsendt uden overhovedet at have bedt om den, hvor hemmeligt er netværket så egentlig?
Det betyder ikke, at Google nødvendigvis har modtaget præcis det samme regneark. Det ved vi ikke.
Men det forekommer efter min mening naivt at basere en langsigtet linkstrategi på en antagelse om, at Googles spamteams og systemer arbejder i en isoleret osteklokke uden kendskab til et marked, som bliver markedsført forholdsvis åbent.
Måske bør man i stedet spørge:
Hvorfor står dette website overhovedet på en prisliste over steder, hvor jeg kan købe et link?
AI har gjort det muligt at skrue voldsomt op for produktionen
Generativ AI har samtidig ændret økonomien i produktionen af indhold.
Hvor det tidligere kostede tid eller penge at fremstille 50 eller 100 nogenlunde sammenhængende artikler, kan store mængder tekst nu produceres meget hurtigt.
Det gør det muligt at tilbyde 10, 50 eller 100 nye artikler om måneden.
Teksterne kan være grammatisk korrekte og se ganske fornuftige ud. Der kan tilføjes stockfoto, overskrifter, interne links og måske et til tre kommercielle links.
Og så kan der lægges et link til Wikipedia, en offentlig myndighed, et universitet eller en anden autoritativ kilde ind i artiklen.
På overfladen begynder det at ligne en rigtig redaktionel artikel.
Men spørgsmålet er stadig:
Hvorfor eksisterer artiklen?
Er den skrevet, fordi et website har noget relevant at fortælle sine brugere?
Eller er artiklen produceret, fordi der skulle oprettes en side omkring et bestemt link?
Det er vigtigt at understrege, at AI i sig selv ikke er problemet.
Googles politik om scaled content abuse handler om produktion af mange sider primært med det formål at manipulere søgeresultater frem for at hjælpe brugerne – uanset om indholdet er produceret af mennesker, AI eller en kombination.
Wikipedia-linket, der skal få det hele til at se naturligt ud
Nogle af de teknikker, der nu anvendes sammen med AI-produceret indhold, er slet ikke nye.
Jeg kan huske tilsvarende tankegange fra omkring 2008 og årene derefter.
En artikel med et kommercielt link skulle helst også indeholde et link til en autoritativ kilde. Wikipedia var oplagt. Det kunne også være en myndighed, organisation eller et universitet.
Tanken var blandt andet, at artiklen dermed fik et mere naturligt linkmønster og måske fremstod mere troværdig.
I dag ser jeg igen konstruktionen:
AI-tekst + stockfoto + 1-3 ønskede links + et autoritativt link.
Men et link til Wikipedia gør ikke automatisk en artikel autoritativ, og et link til en offentlig myndighed skaber ikke i sig selv en redaktionel sammenhæng.
Hvis jeg skriver om dansk selskabsret og henviser til Erhvervsstyrelsen, kan det naturligvis være relevant og nyttigt.
Hvis et autoritativt link derimod hovedsageligt bliver tilføjet efter en fast SEO-opskrift for at få artiklen til at se mere naturlig ud, er situationen en anden.
Det er relevansen og sammenhængen, der er interessant – ikke at der tilfældigvis findes et link til Wikipedia.
Google behøver ikke nødvendigvis vurdere én artikel isoleret
Forestil dig ikke én artikel, men tusindvis.
De har forskellige tekster, stockfotos, emner, domæner, IP-adresser og ankertekster.
Men hvis den grundlæggende konstruktion igen og igen er:
Artikel → kommercielt link → kommercielt link → autoritativt link
så er spørgsmålet, om variationen på overfladen også er reel variation i den underliggende struktur.
Det interessante er mønstret på tværs af dem.
En lille teknisk stikprøve
I forbindelse med udviklingen af min egen Linktjekker besluttede jeg derfor at undersøge en gruppe danske websites med eksterne linkprofiler.
Domæner og aktører er anonymiseret her.
Formålet er ikke at udpege bestemte virksomheder eller websites, men at undersøge, om der kan observeres en genkendelig struktur alene ud fra den måde, eksterne links bliver publiceret på.
Jeg var især interesseret i noget meget lavpraktisk:
Gentager den samme destinationsstruktur sig på flere sider og på tværs af forskellige eksterne domæner?
Et eksempel kan være, at en ekstern destination først linkes via sit navn eller domæne og derefter igen gennem et handlingslink som eksempelvis “Besøg”.
En enkelt forekomst er naturligvis ikke interessant. Mange helt almindelige websites kan have den slags konstruktioner.
Det bliver først interessant, hvis samme model gentager sig på flere sider og samtidig anvendes over for flere forskellige destinationer.
FAKTA: Hvad kan Linktjekkeren bruges til?
Online Marketings Den øde ø – Linktjekker er udviklet til at undersøge mere end blot, om et eksternt link findes på en side.
Værktøjet foretager en begrænset teknisk stikprøve af den side, hvor linket er placeret, og af den interne struktur omkring siden.
Linktjekkeren kan blandt andet anvendes til at undersøge:
• sponsorerede artikler og advertorials
• købte eller tilbudte SEO-links
• PBN-sider og mulige linkmiljøer
• kataloger og link-hubs
• om den konkrete side indgår naturligt i websitets interne struktur
• om der findes en intern vej fra forside eller sektion frem til siden
• sitemap, canonical, HTTP-status og indekseringssignaler
• det konkrete udgående link og dets rel-attributter
• hvilke typer sider og eksterne destinationer der findes omkring den undersøgte placering
Formålet er ikke at stemple et website som PBN, linkfarm eller spam. Linktjekkeren viser tekniske observationer og mønstre, som efterfølgende kan vurderes.
Testen er en stikprøve og ikke en fuld crawl. Et manglende fund er derfor heller ikke dokumentation for, at en forbindelse ikke eksisterer andre steder på websitet.
Prøv Linktjekkeren: www.onlinemarketing.dk/linktjekker.html
Hvorfor er domænerne anonyme?
Man kan argumentere for, at det er en svaghed ikke at lægge de konkrete domænenavne frem. Men målet med stikprøven er ikke at optrævle specifikke netværk. Det interessante er det tekniske mønster, som analysen afslører.
At fælde dom over enkelte linkbyggere eller netværk er Googles bord – hvis de vel at mærke vælger ikke at give kredit til links, der benytter bestemte metoder. Her fokuserer vi udelukkende på det fodaftryk, metoden efterlader.
Hvad viste stikprøven?
På tre anonymiserede websites kunne Linktjekkeren observere et gentaget mønster.
På Website A blev den gentagne destinationsstruktur fundet på 3 af 8 undersøgte sider – svarende til 37,5 %. Mønstret omfattede 6 forskellige destinationsdomæner.
På Website B blev strukturen fundet på 3 af 6 undersøgte sider, altså 50 %, og omfattede ligeledes 6 forskellige destinationsdomæner.
På Website C var mønstret endnu tydeligere. Her blev det observeret på 5 af 8 undersøgte sider, svarende til 62,5 %, og omfattede 10 forskellige destinationsdomæner.
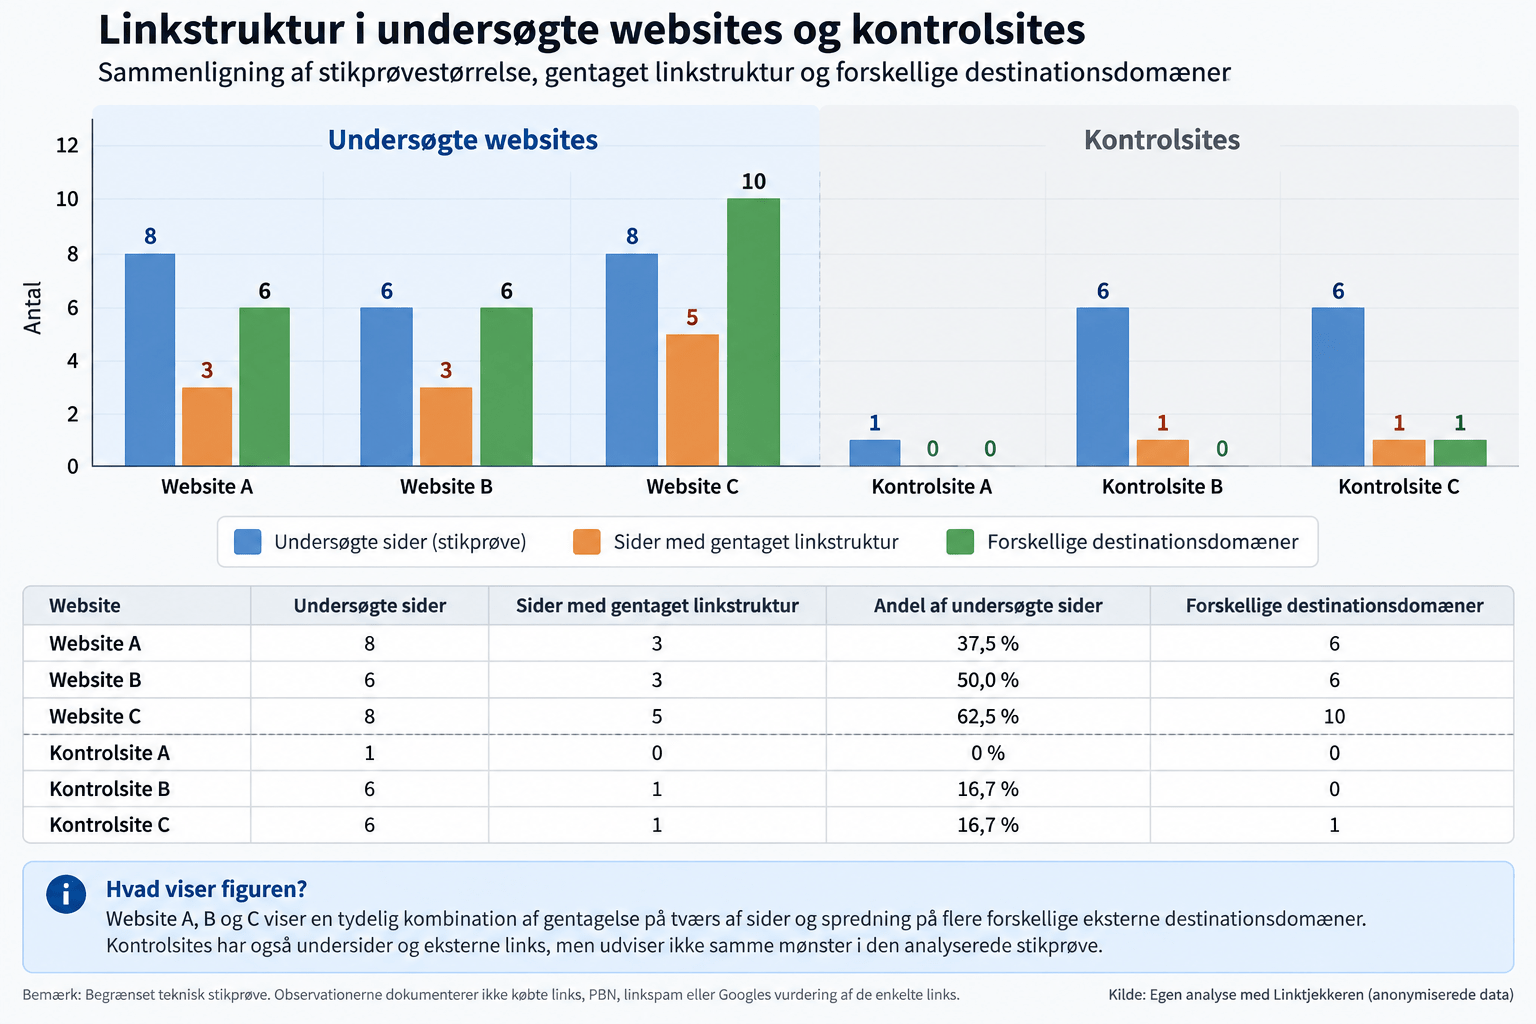
Gentaget linkstruktur og destinationsspredning – Website A, B og C sammenholdt med kontrolsites.
Figuren viser to ting på samme tid.
Der er spredning: Links peger mod forskellige eksterne domæner.
Men der er samtidig gentagelse: Måden, hvorpå destinationerne bliver præsenteret og linket, går igen på tværs af siderne.
Det er netop kombinationen, der er interessant.
Men reagerer testen bare på websites med mange links?
Det var selvfølgelig det næste spørgsmål.
Et website kan have hundredvis eller hundredtusindvis af sider og linke til et stort antal forskellige virksomheder uden at være del af noget konstrueret linkmiljø.
Virksomhedsdatabaser, brancheportaler og andre store informationssites gør netop dette helt naturligt.
Derfor blev samme analyse kørt på tre uafhængige kontrolsites.
Kontrolsites havde også strukturerede undersider, forskellige emneområder og almindelige eksterne links. Ét af dem havde mere end 800.000 registrerede URL’er.
Alligevel så resultatet anderledes ud.
På Kontrolsite A blev den gentagne struktur ikke observeret på den undersøgte side.
På Kontrolsite B blev den fundet på 1 af 6 sider, og på Kontrolsite C ligeledes på 1 af 6 sider – svarende til 16,7 % i begge tilfælde.
Det er vigtigt, for enkelte forekomster skal netop kunne eksistere på helt almindelige websites uden at blive gjort til noget mistænkeligt.
Det interessante er ikke en bestemt HTML-konstruktion eller et enkelt link.
Det er gentagelsen af strukturen på tværs af sider og forskellige destinationer.
Hvad dokumenterer det så?
Ikke at et bestemt link er købt.
Ikke at de undersøgte websites er et PBN.
Ikke at Google har identificeret eller devalueret de pågældende links.
Og heller ikke, at websites med en bestemt linkstruktur automatisk er problematiske.
Det ville være at gå længere, end data kan bære.
Det, stikprøven viser, er noget mere enkelt:
En ensartet måde at distribuere eksterne links på kan efterlade et teknisk observerbart mønster.
Og det er værd at have med, når man taler om diversitet i linkbuilding.
Men hvem står egentlig bag websitet?
Der er samtidig en helt anden faktor, som let bliver overset, når værdien af et link vurderes:
Hvem står egentlig bag det website, linket kommer fra?
I linkbuilding bliver der ofte fokuseret på metrics, domænealder, trafikestimater og antallet af referring domains.
Men prøv også at besøge websitet som en almindelig bruger.
Hvem ejer det?
Hvem skriver indholdet?
Er der en virksomhed, organisation eller redaktion bag?
Kan man identificere den ansvarlige?
Findes der en fysisk adresse eller virksomhedsoplysninger?
Eller består kontaktmuligheden alene af en formular eller en generisk e-mailadresse?
Manglende fysisk adresse eller ejeroplysninger er naturligvis ikke i sig selv dokumentation for, at et website er et PBN, sælger links eller har lav kvalitet.
Der findes mange helt legitime websites og mindre projekter, hvor ejeren ikke offentliggør en fysisk adresse.
Men sammenhængen bliver interessant.
På flere websites og hos linkudbydere møder man formuleringer som “udvalgte kvalitetssider”, “kvalitetslinks” og “stærke links”.
Det lyder betryggende.
Men hvad betyder “kvalitet” egentlig?
Hvem har vurderet kvaliteten – og efter hvilke kriterier?
Er det kvaliteten og den faglige relevans af indholdet?
En reel redaktion og målgruppe?
Reelle besøgende?
SEO-metrics som domænealder, backlinks og estimeret trafik?
Eller betyder “udvalgt kvalitetsside” i praksis blot, at websitet er godkendt til at indgå i udbyderens katalog over steder, hvor der kan købes en publicering?
Hvis man samtidig ikke kan identificere, hvem der ejer eller redaktionelt står bag websitet, bliver kvalitetsbetegnelsen endnu vanskeligere at vurdere.
Et gammelt domæne er ikke nødvendigvis et kvalitetswebsite.
En høj tredjepartsmetric er ikke nødvendigvis redaktionel kvalitet.
Mange backlinks er ikke nødvendigvis faglig autoritet.
Derfor synes jeg, at man som køber bør stille et enkelt spørgsmål, når man præsenteres for “udvalgte kvalitetssider”:
Udvalgt af hvem – og på baggrund af hvad?
Hvis et website samtidig markedsføres gennem begreber som “kvalitetslinks” og “SEO-værdi”, mens det er vanskeligt at finde ud af, hvem der faktisk driver websitet, opstår et andet spørgsmål:
Hvem er websitet egentlig lavet til?
Er det lavet til en målgruppe, der forventes at læse indholdet?
Eller er den vigtigste funktion at publicere sider, som kan indeholde eksterne links?
Ville websitet eksistere uden linkbuilding?
Det er måske et af de mest interessante spørgsmål, man kan stille:
Ville dette website stadig give mening, hvis muligheden for at sælge eller placere links forsvandt i morgen?
Et fagmedie, en brancheportal, en virksomhedsblog eller et nichewebsite har normalt et selvstændigt formål.
Brugeren kommer for at finde information, følge et emne, undersøge virksomheder, købe et produkt eller benytte en tjeneste.
Et website, der hovedsageligt eksisterer som distributionskanal for SEO-artikler og eksterne links, kan have et andet udgangspunkt.
Det kan have tusindvis af indekserede sider, professionelt design, et gammelt domæne og flotte tal i SEO-værktøjerne.
Men hvor mange mennesker kommer faktisk ind på websitet for at bruge websitet?
Og hvis en rigtig bruger lander på en artikel, hvem giver så rådene? Hvem står bag? Hvorfor skal brugeren have tillid til indholdet?
Det er spørgsmål, der sjældent fremgår af en backlinkrapport.
Et gammelt domæne er ikke nødvendigvis et gammelt website
Domænealder og historiske backlinks bliver ofte fremhævet som kvalitetsparametre.
Men et domæne kan være gammelt uden, at det nuværende website er gammelt.
Domænet kan tidligere have tilhørt en virksomhed, forening eller et projekt og senere være registreret af en ny ejer.
Den historiske backlinkprofil kan stadig eksistere.
Men domænets historiske identitet og det nuværende websites identitet er ikke nødvendigvis den samme.
Google har en særskilt spamkategori kaldet Expired Domain Abuse.
Det betyder ikke, at det er problematisk at købe eller genanvende et gammelt domæne. Googles definition handler om udløbne domæner, der købes og genanvendes primært med det formål at manipulere søgeresultaterne gennem indhold med ringe eller ingen værdi for brugerne.
Derfor kan historiske data være interessante.
Hvad indeholdt domænet tidligere?
Hvornår ændrede indholdet karakter?
Hvornår begyndte den nuværende type artikler at blive publiceret?
Og er de websites, som historisk linkede til domænet, overhovedet relevante for det website, der findes på domænet i dag?
Et netværk behøver ikke ligne et netværk
Diskussionen om PBN’er, hubs og linknetværk bliver derfor for snæver, hvis den alene handler om fælles IP-adresser.
Det moderne footprint kan være gentagne destinationsmønstre, bestemte kommercielle brancher, publiceringsmønstre, domænehistorik, tekniske identifikatorer eller domæner, der igen og igen optræder på lister over websites, hvor links kan købes.
Det kan også være noget så grundlæggende som, at en gruppe tilsyneladende uafhængige websites alle har det samme problem:
Det er svært at finde ud af, hvem der egentlig står bag dem, hvem der bruger dem, og hvorfor de eksisterer.
Det enkelte signal beviser ikke ret meget.
Men kombinationen af mange signaler kan tegne et mønster.
Det er ikke et angreb på branchen, der sælger links
Det er vigtigt for mig at understrege, at denne artikel ikke er et generelt angreb på den branche, der arbejder med eller sælger links.
Jeg har selv tidligere erfaring med denne del af linkbuilding.
Det, jeg forholder mig kritisk til, er de problemfelter, jeg gennem snart 30 år i branchen har set opstå omkring forskellige former for linkbuilding – og især den måde, mange af metoderne i dag bliver skaleret og markedsført på.
Noget af det interessante er faktisk, hvor lidt der grundlæggende er nyt.
En del af de teknikker, vi ser i dag, minder om metoder, der blev anvendt i 00’erne: linkkataloger, artikeldatabaser, netværk af websites, udløbne domæner, varierende ankertekster og forsøg på at få konstruerede links til at ligne naturlige redaktionelle anbefalinger.
I dag har teknikkerne fået en ny indpakning med cloud-hosting, avancerede SEO-metrics, dashboards, automatiseret publicering og AI-genererede tekster.
Men det grundlæggende formål kan i nogle tilfælde være det samme:
At skabe et link, som over for en søgemaskine helst skal ligne noget, der er opstået naturligt.
Det er her, jeg mener, man bør tænke langsigtet.
Mit fokus ville ikke være at opbygge så mange links som muligt fra en liste over tilgængelige domæner.
Det ville være at opbygge en linkstruktur til websitet, hvor forbindelserne ikke ligger og flyder i regneark og dashboards, som stort set enhver interesseret kan få adgang til på få minutter.
Et link bliver ikke automatisk dårligt, fordi domænet står i et regneark. Men regnearket kan gøre det betydeligt lettere at kortlægge det miljø, linket kommer fra.
Marts 2024 viste, at oprydningen kan være voldsom
Historien er værd at huske, fordi Google flere gange har ændret sin håndtering af metoder, der i en periode har fungeret.
I marts 2024 kom et tydeligt eksempel.
Google lancerede en omfattende Core Update og nye spamregler, hvor blandt andet Expired Domain Abuse og Scaled Content Abuse blev defineret eksplicit.
Expired Domain Abuse handler ikke om, at det i sig selv er forkert at købe et gammelt domæne. Problemet opstår ifølge Google, når et udløbet domæne købes og genanvendes primært med det formål at manipulere søgeresultaterne gennem indhold med ringe eller ingen værdi for brugerne.
Scaled Content Abuse handler tilsvarende om produktion af store mængder sider primært med det formål at manipulere søgeresultaterne frem for at hjælpe brugerne.
Det afgørende er ikke alene, om indholdet er produceret af AI, mennesker eller en kombination. Det er formålet med den skalerede produktion, der er centralt.
Det er interessant i forhold til nutidens linkmiljøer, fordi AI gør det muligt billigt at fremstille 10, 50 eller 100 artikler om måneden til websites, hvis væsentligste kommercielle værdi måske netop er muligheden for at publicere eksterne links.
837 websites blev registreret som fjernet fra Google
Der kom samtidig meget synlige konsekvenser i forbindelse med marts 2024-opdateringen.
SEO-specialisten Ian Nuttall fulgte ifølge Search Engine Journal 49.345 websites og registrerede i de første dage 837 websites, som var fjernet helt fra Googles indeks.
De pågældende websites havde før indgrebet tilsammen estimeret mere end 20,7 millioner månedlige organiske besøg.
Det er vigtigt at være præcis:
De 837 websites er ikke et officielt Google-tal.
Det er resultatet af en ekstern undersøgelse, og nogle af de registrerede websites begyndte efterfølgende at dukke op i indekset igen.
Tallet dokumenterer derfor ikke, at Google permanent slettede præcis 837 PBN’er eller linksites.
Men undersøgelsen illustrerer, hvor voldsomt konsekvenserne kan blive, når et website ikke blot mister nogle placeringer, men forsvinder fra Googles indeks.
Et link, der bliver devalueret, holder måske blot op med at overføre den værdi, man havde håbet på.
Hvis selve websitet, som linket ligger på, mister sin tilstedeværelse i Google, er situationen en anden.
SpamBrain og kunstig intelligens ændrer spillet
Allerede i december 2022 beskrev Google SpamBrain som sit AI-baserede spamforebyggelsessystem og oplyste i forbindelse med en linkspam-opdatering, at systemet kunne anvendes til at identificere både websites, der køber links, og websites, der anvendes med det formål at sende udgående links.
Det betyder ikke, at SpamBrain finder alle købte links.
Og vi kan udefra ikke afgøre præcis, hvilke signaler Google anvender.
Men vi ved, at Google anvender kunstig intelligens i arbejdet med linkspam, og at relationen mellem websites, der køber links, og websites, der anvendes til at distribuere dem, indgår i Googles egen beskrivelse af systemet.
Det er netop derfor, footprints bliver interessante.
Hvis mit lille program kan finde mønstret …
Det er også her, mine egne eksperimenter med Linktjekkeren bliver interessante.
Linktjekkeren er naturligvis ikke Google.
Den har ikke adgang til Googles indeks, Googles linkgraf, Googles historiske crawldata eller Googles ressourcer.
Den foretager forholdsvis små tekniske stikprøver.
Alligevel kan et relativt lille lokalt udviklet program finde gentagne destinationsstrukturer og andre mønstre på tværs af websites.
Som gennemgangen tidligere i artiklen viste, fandt Linktjekkeren eksempelvis den gentagne struktur på 37,5 %, 50 % og 62,5 % af de undersøgte sider på de tre anonymiserede websites.
Det beviser ikke, at Google anvender de samme metoder.
Det beviser heller ikke, at Google har identificeret de websites, jeg har undersøgt.
Men det giver anledning til en naturlig overvejelse:
Hvis jeg med begrænsede ressourcer, nogle få stikprøver og et lille program kan finde gentagne strukturer, hvad kan en søgemaskine med en enorm linkgraf, historiske crawldata, avancerede systemer og kunstig intelligens så potentielt sammenholde?
Man behøver ikke kende Googles algoritme for at stille det spørgsmål.
Hvis man arbejder med linkbuilding for en virksomhed, der også skal eksistere og rangere om fem eller ti år, er der efter min mening et endnu vigtigere spørgsmål:
Er dette en linkstruktur, jeg også vil være tryg ved, at Google kan kortlægge om fem år?
Historien har flere gange vist, at en metode godt kan fungere, indtil den dag den ikke gør.
Fra katalog til regneark
Udviklingen kan meget forenklet beskrives sådan:
Det oprindelige linkkatalog: Brugeren finder et relevant website.
Artikeldatabasen: Afsenderen publicerer en artikel og får mulighed for at placere et link.
Linkudbyderens salgskatalog: Kunden får et regneark, et login eller adgang til en online database og vælger det website, hvor linket skal placeres.
AI-skala: Artiklerne kan nu produceres i langt større mængder og distribueres på tværs af de websites, der er tilgængelige gennem systemet.
Vi er derfor ikke vendt tilbage til det gamle linkkatalog.
Vi har fået noget andet.
Det gamle katalog organiserede internettet for brugeren.
Det nye katalog organiserer publiceringsmulighederne for linkkøberen.
Domænediversitet er ikke nødvendigvis reel diversitet
Det er derfor værd at være forsigtig med udsagn som:
“Du får links fra 20 forskellige domæner.”
“Alle websites ligger på forskellige IP-adresser.”
“Vi bruger kun stærke domæner.”
Det kan alt sammen være faktuelt korrekt.
Men det besvarer ikke nødvendigvis det vigtigste spørgsmål:
Hvor uafhængige er de 20 websites egentlig?
For diversitet kan måles på mange måder.
Der er teknisk diversitet.
Der er domænediversitet.
Der er ejermæssig diversitet.
Der er redaktionel diversitet.
Og så er der den måske vigtigste form:
Reel diversitet i formål, brugere og identitet.
Forskellige IP-adresser kan være forskellige IP-adresser.
Ti domæner kan være ti domæner.
Hundrede forskellige AI-genererede artikler kan være hundrede forskellige tekster.
Men ingen af delene dokumenterer i sig selv, at vi har at gøre med hundrede uafhængige redaktionelle anbefalinger af de websites, der linkes til.
Og hvis relativt enkle tekniske stikprøver kan finde gentagne strukturer på tværs af websites, er det naturlige næste spørgsmål:
Hvad kan der så observeres, når man har adgang til en langt større linkgraf og kan sammenholde mønstre på tværs af millioner eller milliarder af sider?
Så måske er spørgsmålet ikke længere kun:
“Kan Google finde mit link?”
Det mere interessante spørgsmål kan være:
“Hvor meget kan Google se omkring det?”
Det vender jeg tilbage til i Del 6: AI, linkgrafen og linklossepladsen.
René Madsen har arbejdet professionelt med søgemaskiner og SEO siden 1999. Han har fulgt udviklingen fra de tidlige søgemaskiner og PageRank til Googles nuværende søgesystemer og har gennem årene arbejdet praktisk med blandt andet linkbuilding, linkprofiler og analyse af links. I forbindelse med denne artikel er der desuden anvendt data fra egenudviklede værktøjer til analyse af linkstrukturer og tekniske footprints.
Virksomhedsnavn: Online Marketing
CVR: 18930099
Etableret: 1995
Professionel SEO siden: 1999
Officiel virksomhedsregistrering:
Datacvr
Denne artikel er femte del i serien Linkbuilding – fra PageRank til AI og linklossepladsen
✔ Del 1: Links er ikke døde – men ikke alle links fortjener at leve
✔ Del 2: Den øde ø – hvor meget er dit link egentlig værd?
✔ Del 3: Fra linkkataloger til industrielle linkmarkeder
✔ Del 4: Tier linkbuilding – da vi byggede links til vores links
✔ Del 5: PBN, forskellige IP-adresser og “diversitet” (du læser den nu)
✔ Del 6: AI, linkgrafen og linklossepladsen
✔ Del 7: Hvis vi ikke skal købe links, hvad skal vi så gøre?
De kommende dele offentliggøres løbende.